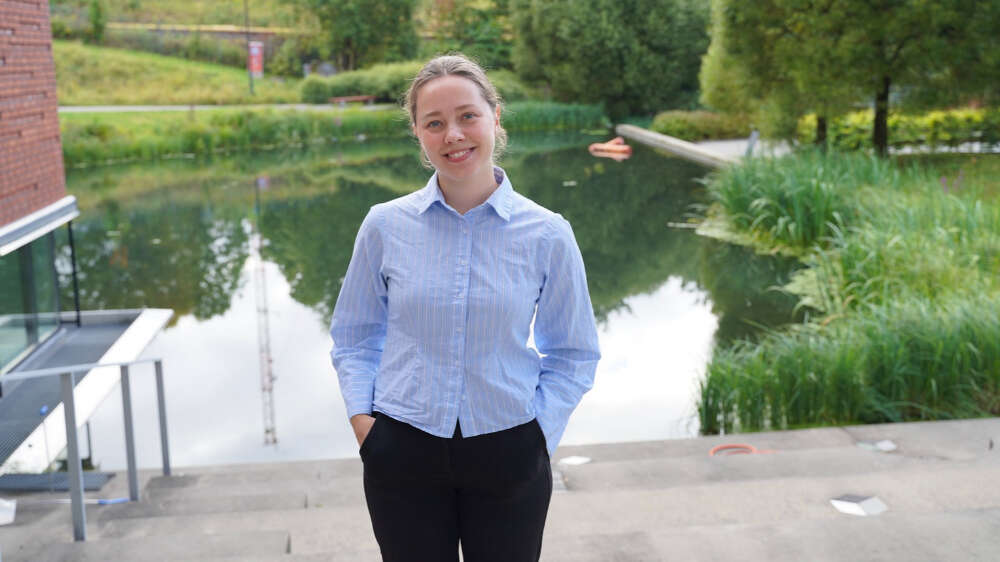
Lilja Charlotte Storset er forsker i Language Technology Group (LTG) ved Institutt for informatikk på Universitetet i Oslo. De siste to årene har hun jobbet med et prosjekt i samarbeid med Folkehelseinstituttet (FHI), der hun og kollegaene undersøker hvordan kunstig intelligens kan brukes til å analysere store mengder pasientkommentarer.
Når titusenvis av pasientkommentarer skal analyseres
Utgangspunktet for prosjektet Lilja jobber med, er pasientkommentarer fra årlige spørreundersøkelser, der pasientene kan skrive fritt om opplevelsene sine i helsetjenesten.
– FHI ønsker å analysere kommentarene for å kunne forbedre helsetjenesten. Problemet er mengden. De får titusenvis av kommentarer hvert år. Tidligere har de hovedsakelig brukt manuelle metoder, og da har de bare fått analysert en liten andel.
Hun og kollegaene hennes forsøker derfor å automatisere analysen.
– Vi utvikler modeller som gjenkjenner sentimentet i pasientkommentarene. Det vil si om de er positive, negative, nøytrale eller blandede.
Metoden kalles sentimentanalyse, og forskerne har allerede testet den på kommentarene.
– Vi har testet ut en del og sett at det fungerer ganske bra. Det er både vi og FHI veldig glade for. Nå har de mulighet til å analysere absolutt alle pasientkommentarene de får.
Hva er pasienten egentlig misfornøyd med?
Nå har prosjektet gått et steg videre, til det som kalles aspektbasert sentimentanalyse.
– Metoden bygger på den samme ideen, men i stedet for bare å finne ut om en kommentar er positiv eller negativ, kobles sentimentet til et bestemt tema.
Forskerne har definert rundt 25 temaer som er relevante for helsetjenesten.
– Det kan for eksempel være ventetid. En modell kan da identifisere at en pasient er fornøyd eller misfornøyd med ventetiden. Andre temaer kan være relasjonen mellom pasient og ansatt, opplevelsen av det fysiske venterommet, avstanden til fastlegen eller hvordan det oppleves å bestille time digitalt.
På den måten kan store mengder pasientkommentarer analyseres etter både tema og sentiment.
For Lilja er det nettopp muligheten til å bruke forskningen i praksis som gjør prosjektet så spennende.
– Det er faktisk noen som får bruk for det.
Hva gjør engelsk med språkmodellene?
Helseprosjektet er ikke det eneste Lilja jobber med. Hun er også ansatt på et prosjekt som handler om kulturell sensitivitet i store språkmodeller. Her ser hun blant annet på hvilken betydning det kan ha at språkmodellene har sett mye engelsk, og mindre av andre språk.
– En del modeller, sånn som ChatGPT, har sett utrolig masse engelsk. Gjerne veldig mye av det, og veldig lite av andre mindre språk, som for eksempel norsk.
Hun er interessert i hvilken innflytelse dette kan ha på modellene.
– Det er interessant språklig, men også verdimessig, i og med at USA er i en litt spesiell situasjon.
Hun synes også det er spennende å jobbe med et felt som utvikler seg så raskt.
– Det her med språkmodeller, chatbots og lignende er veldig i vinden, så det er aktuelt som aldri før.
Varierte dager med mye frihet
Det beste med jobben er ifølge Lilja friheten.
– Det er frihet under eget ansvar. Man legger opp dagen litt som det passer en.
Arbeidsdagene kan derfor se svært forskjellige ut. Noen dager går med til å skrive søknader om forskningsmidler eller forskningsartikler. Andre dager handler om å lese tidligere forskning og utvikle ideer til nye prosjekter.
– Hvis man er i oppstarten av et prosjekt, bruker man tid på å lese artikler og notere for å prøve å bygge opp en idé om hvilken fremgangsmåte eller modelleringsoppsett man skal bruke.
Å forske handler også om å dele det man har gjort.
– Da skriver man artikler og presenterer det. Den delen er litt skummel, men man blir fort vant til det. Det er veldig gøy å få høre om hva alle andre har gjort også, og så får man reist masse.
Nylig har hun blant annet vært på konferanser i Marokko og København.
– Det var kjempekult!
Vær interessert, vær nysgjerrig!
Til de som er interessert i språkteknologi og kan tenke seg å studere Informatikk: maskinlæring og kunstig intelligens, har Lilja et enkelt råd:
– Vær interessert, vær nysgjerrig!
Hun trekker også frem hvor variert studiet er.
– Man lærer å programmere, og det er ikke nødvendig å ha erfaring med det fra før. Jeg hadde aldri programmert før jeg begynte. Man lærer også lingvistikk, altså å studere og analysere språk, som kommer godt med når man jobber med modellering av språk.
Tverrfagligheten er noe av det hun liker best med både studiet og jobben.
– Det er mindre lett å bli lei. Du får jobbe med så mye forskjellig. I tillegg er studentmiljøet veldig bra. Man hjelper hverandre og finner på masse gøy.
Avslutningsvis vil hun også minne om at det er lov å ombestemme seg underveis.
– Det er helt greit å begynne på et nytt studium dersom man finner ut at det man går på ikke passer helt.
Tekst og foto: Erle Widme
Lilja Charlotte Storset
Stilling: Forsker
Arbeidsplass: Språkteknologigruppa ved UiO
Utdanning fra UiO:
Bachelor i: Informatikk: Språkteknologi, erstattet av: Informatikk: Maskinlæring og kunstig intelligens
Master i: Informatikk: Språkteknologi, som nå er en studieretning på masterprogrammet: Informatikk: maskinlæring og kunstig intelligens.